Diese Woche versammelten sich die globale Computer- und High-Performance-Computing-Infrastrukturbranche (HPC) in Chicago zur Supercomputing 2026 (SC26). Wenn in den Vorjahren Gespräche von der Knappheit einzelner Chips dominiert wurden, hat sich der Hauptfokus der diesjährigen SC26 vollständig auf die Rack-Scale-Architektur verlagert, bei der ein kompletter Serverschrank als eine einzige, miteinander verbundene Rieseneinheit betrachtet wird.
Zwei große Ankündigungen stahlen die Show: das wettbewerbsfähige Debüt des NVIDIA Vera Rubin NVL72, das im Industriebentchmark MLPerf direkt neue Rekorde aufstellte, sowie der Schritt von ASUS, die Massenauslieferung der flüssigkeitsgekühlten Rack-Systeme AI POD XA VR721-E3 zu beschleunigen und gleichzeitig den lokalen KI-Zugriff auf Verbraucher-PCs und Workstations zu erweitern.
1. Architektur-Analyse des NVIDIA Vera Rubin NVL72
Im Gegensatz zu herkömmlichen Servern, die die GPU-zu-GPU-Kommunikation innerhalb eines einzelnen Chassis begrenzen, ist die Vera Rubin NVL72-Plattform als ein einziges, integriertes Rechen-Domain im Rack-Maßstab konzipiert. Laut dem offiziellen DGX Vera Rubin NVL72 Datenblatt integriert ein einzelnes Rack 72 NVIDIA Rubin GPUs und 36 NVIDIA Vera CPUs (basierend auf Arm-kompatiblen Sonderanfertigungen), die kohärent zusammenarbeiten.
a. HBM4-Speichersprung und NVLink 6 Interconnect
Der Bedarf an Training für Billionen-Parameter-Modelle und KI-Agenten-Reasoning erfordert eine extrem schnelle Datenversorgung der Rechenkerne. Um dies zu beantworten, bringt die Vera Rubin-Architektur drei Hauptfundamente mit sich:
- Massive HBM4-Kapazität: Jede Rubin-GPU ist mit bis zu 288 GB HBM4-Speicher ausgestattet, was insgesamt 20,7 TB HBM4-Speicher in einem einzigen Rack mit einer aggregierten Bandbreite im Petabyte-Bereich pro Sekunde (ca. 1,4–1,6 PB/s je nach Konfiguration) ergibt.
- Sechste Generation von NVLink: Unterwegs mit neun NVLink 6-Switch-Trays erreicht der Scale-Up-Kommunikationspfad zwischen den GPUs in einem Rack 216 TB/s bis 260 TB/s, wodurch Engpässe beseitigt werden, wenn Tausende von Modellparametern Gradienten austauschen.
- High-Density Scale-Out-Netzwerk: Zur Verbindung zahlreicher Racks zu einem Supercomputer-Cluster kombiniert das System 144 ConnectX-9 SuperNICs und 18 BlueField-4 DPUs, um den Hochgeschwindigkeits-InfiniBand- und Spectrum-X-Ethernet-Datenverkehr zu unterstützen.
2. Abgesang auf MLPerf Training v6.1 und Endpoints v1.0
Die Behauptung der neuen Architektur wurde direkt in der offiziellen MLPerf-Benchmark-Runde im November 2026 getestet, bei der das Vera Rubin NVL72 sein Debüt gegen Systeme der vorherigen Generation feierte.
a. Verdoppelte Trainingsleistung pro GPU
In den offiziellen Ergebnissen von MLPerf Training v6.1 verzeichnete NVIDIA, dass das Vera Rubin NVL72 im Vergleich zum bereits ausgereiften GB300 NVL72 (Blackwell Ultra)-System eine um das bis zu 2-fache höhere Leistung pro GPU erbringen kann. Neben dem Ausräumen sämtlicher Testkategorien zeigte das System eine Skalierungseffizienz von über 97 %, wenn das Cluster von 256 auf 1.024 GPUs erweitert wurde.
b. Energieeffizienz des KI-Agenten-Inferenzbetriebs
Unterdessen verlagerte sich beim MLPerf Endpoints v1.0 Test für Agenten-Inferenz der Fokus auf das Verhältnis von Durchsatz zu Stromverbrauch. Bei modernen Deep-Reasoning- und multimodalen Modellarbeitslasten (wie Qwen3-VL und DeepSeek-Varianten) verzeichnete das Vera Rubin NVL72 eine Effizienzsteigerung von mehr als dem 10-fachen Durchsatz pro Kilowatt im Vergleich zu Racksystemen vorheriger Generationen – ein entscheidender Indikator, da Strom- und Kühlungskosten mittlerweile das größte Hindernis für die Expansion von KI-Rechenzentren darstellen.
3. ASUS beschleunigt Auslieferung des AI POD XA VR721-E3 & Local AI Expansion
Auf Seiten der Ökosystem-Partner nutzte ASUS die Bühne der SC26, um die Massenproduktionsbereitschaft zu demonstrieren. Durch die Ankündigung der ASUS Vera Rubin NVL72 Auslieferung bestätigte das Unternehmen eine beschleunigte Produktion und vollständige Auslieferung im vierten Quartal 2026 für sein Flaggschiff, den ASUS AI POD XA VR721-E3.
a. Vollständige Flüssigkühlung und sechschichtige Validierung
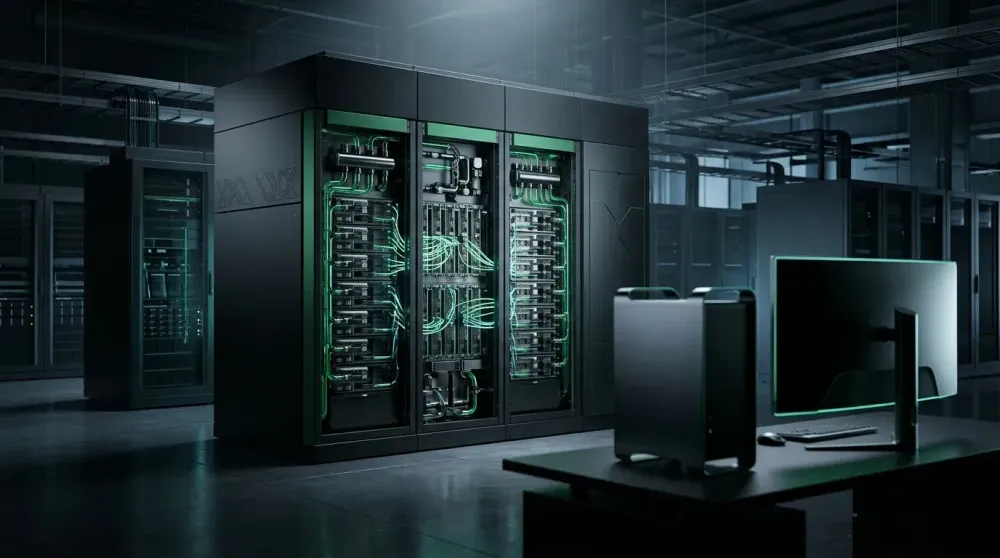
Da ein einzelnes XA VR721-E3-Rack vier 110-kW-Netzteil-Shelves mit einem Spitzenleistungsbedarf von bis zu 227 kW unterstützt, reichen herkömmliche Luftkühlsysteme nicht mehr aus. Daher setzt ASUS auf eine 100 % flüssigkeitsgekühlte Architektur und stützt sich auf automatisierte L10/L11-Montagelinien, die mit optischer Inspektion und Präzisionsverschraubung ausgestattet sind. Jedes Rack muss zudem einen sechschichtigen Validierungsrahmen durchlaufen – einschließlich thermischer, Firmware- und netzwerkübergreifender Integritätstests –, bevor es an Cloud-Provider oder Unternehmen versendet wird.
b. Bringt KI zu Selbstbau-PCs, Workstations und Desktops
Interessanterweise hört die Strategie von ASUS im riesigen Serverraum nicht auf. Über das Rechenzentrumssegment hinaus kündigte ASUS auch die Expansion des Local-AI-Ökosystems auf PCs an, die DIY-PC-Komponenten (Do-it-Yourself), Gaming-Geräte, Creator-Workstations und professionelle Desktops umfasst. Dieser Schritt zielt darauf ab, die Gesamtbetriebskosten (TCO) für Organisationen und Kreative zu senken, die KI-Agenten-Workflows lokal oder hybrid ausführen möchten, ohne vollständig von der Anmietung von Cloud-Rechenleistung abhängig zu sein.
4. HPC-Roadmap 2027–2028: Wissenschaftliches Rechnen & Quantencomputing
Die SC26 betonte auch, dass die Vera- und Rubin-Architekturen nicht nur für kommerzielle Large Language Models entwickelt wurden. In der Serie von Ankündigungen zur NVIDIA-HPC-Roadmap wurden zwei fortgeschrittene Linien für die wissenschaftliche Forschungsgemeinschaft enthüllt:
- Vera 192-CPU HPC Rack (Anfang 2027): Eine dichte Konfiguration, die die Rechenkapazität von kundenspezifischen Arm-CPUs für physikalische Simulationslasten, Klimamodellierung und speicherintensive Workloads hervorhebt.
- Rubin HPC GPU (2028): Eine spezielle Variante für wissenschaftliches Rechnen mit hoher Präzision, die über 50.000 CUDA-Kerne zusammenbringt, um die naturwissenschaftliche Forschung und Quantensimulationen der nächsten Generation voranzutreiben.
Fazit
Die SC26 in Chicago zeigte, wie die Grenze zwischen einzelnen Chips und Rechenzentrumsinfrastruktur verschwommen ist. Durch das Vera Rubin NVL72 bewweist NVIDIA, dass der Leistungssprung von 2x pro GPU und die Energieeffizienz von 10x pro Kilowatt nur durch ein Rack-Scale-Design erreicht werden können, das HBM4-Speicher, NVLink 6 und Flüssigkühlung vereint. Gleichzeitig markieren die beschleunigte Produktion des ASUS AI POD XA VR721-E3 und der Vorstoß, Local AI-Beschleunigung in Workstations und DIY-PCs zu bringen, dass diese neue Generation von Rechenleistung bereit ist, von den riesigen Rechenzentren bis an die Arbeitsplätze von Kreativen und Entwicklern weltweit zu fließen.