Cette semaine, l'industrie mondiale de l'informatique et de l'infrastructure de calcul haute performance (High-Performance Computing / HPC) s'est réunie à Chicago pour l'événement Supercomputing 2026 (SC26). Si les années précédentes, les discussions étaient dominées par la pénurie de puces individuelles, le point culminant du SC26 de cette année s'est entièrement déplacé vers l'architecture rack-scale, qui traite une armoire de serveurs entière comme une seule unité informatique géante interconnectée.
Deux annonces majeures ont volé la vedette : les débuts compétitifs du NVIDIA Vera Rubin NVL72, qui a immédiatement établi de nouveaux records lors des tests industriels MLPerf, et la décision d'ASUS d'accélérer la livraison en série de son système de racks refroidis par liquide AI POD XA VR721-E3, tout en élargissant l'accès à l'IA locale sur les PC grand public et les stations de travail.
1. Analyse de l'architecture NVIDIA Vera Rubin NVL72
Contrairement aux serveurs traditionnels qui limitent la communication inter-GPU au sein d'un même châssis, la plateforme Vera Rubin NVL72 est conçue comme un domaine de calcul unifié à l'échelle d'un rack. Selon la fiche technique officielle du DGX Vera Rubin NVL72, un seul rack intègre 72 GPU NVIDIA Rubin et 36 CPU NVIDIA Vera (basés sur des cœurs personnalisés compatibles Arm) fonctionnant de manière cohérente.
a. Un bond en avant avec la mémoire HBM4 et l'interconnexion NVLink 6
La nécessité d'entraîner des modèles à milliards de paramètres et le raisonnement des agents d'IA exigent un apport de données ultra-rapide vers les cœurs de calcul. Pour y répondre, l'architecture Vera Rubin repose sur trois fondements principaux :
- Capacité HBM4 massive : Chaque GPU Rubin est équipé de jusqu'à 288 Go de mémoire HBM4, générant un total de 20,7 To de mémoire HBM4 dans un seul rack avec une bande passante agrégée atteignant l'échelle du pétaoctet par seconde (environ 1,4 à 1,6 Po/s selon la configuration).
- NVLink de sixième génération : Soutenue par neuf tiroirs de commutateurs NVLink 6, la voie de communication scale-up entre les GPU d'un même rack atteint 216 To/s à 260 To/s, éliminant les goulots d'étranglement lorsque des milliers de paramètres de modèles échangent des gradients.
- Réseau Scale-Out à haute densité : Pour connecter plusieurs racks en un cluster de supercalculateurs, le système combine 144 SuperNIC ConnectX-9 et 18 DPU BlueField-4 afin de prendre en charge le trafic InfiniBand et Spectrum-X Ethernet à haut débit.
2. Carton plein aux tests MLPerf Training v6.1 et Endpoints v1.0
Les revendications de cette nouvelle architecture ont été immédiatement mises à l'épreuve lors du cycle de benchmarks officiels MLPerf de novembre 2026, où le Vera Rubin NVL72 a fait ses débuts face aux systèmes de génération précédente.
a. Performance d'entraînement multipliée par 2 par GPU
Dans les résultats officiels de MLPerf Training v6.1, NVIDIA indique que le Vera Rubin NVL72 est capable de fournir des performances jusqu'à 2 fois supérieures par GPU par rapport au système GB300 NVL72 (Blackwell Ultra), pourtant déjà largement optimisé. En plus de balayer toutes les catégories de test, le système affiche une efficacité de mise à l'échelle (scaling efficiency) supérieure à 97 % lorsque le cluster passe de 256 à 1 024 GPU.
b. Efficacité énergétique pour l'inférence des agents d'IA
Parallèlement, lors des tests MLPerf Endpoints v1.0 pour l'inférence d'agents, l'accent a été mis sur le rapport entre le throughput (débit) et la consommation électrique. Sur des charges de travail de modèles de raisonnement profond et multimodaux modernes (tels que Qwen3-VL et les variantes DeepSeek), le Vera Rubin NVL72 a enregistré une augmentation d'efficacité de plus de 10x en termes de débit par kilowatt par rapport aux systèmes de racks de la génération précédente — un indicateur crucial étant donné que les coûts d'électricité et de refroidissement sont désormais le plus grand défi de l'expansion des centres de données d'IA.
3. ASUS accélère la livraison de l'AI POD XA VR721-E3 et l'expansion de l'IA locale
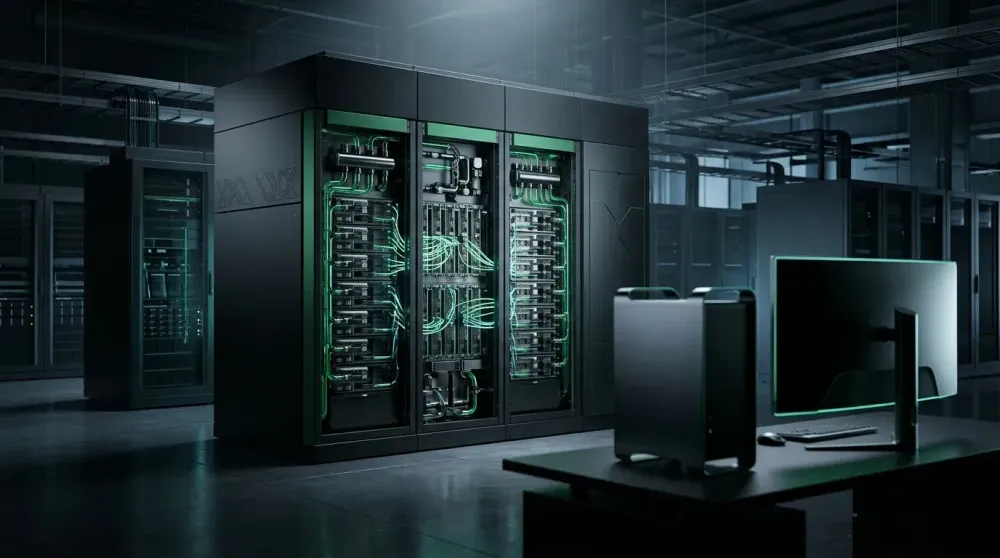
Du côté des partenaires fabricants de l'écosystème, ASUS a profité de la scène du SC26 pour démontrer sa capacité de production en série. Avec l'annonce des livraisons du Vera Rubin NVL72 par ASUS, l'entreprise a confirmé l'accélération de la production et le lancement des livraisons à grande échelle au quatrième trimestre 2026 pour son produit phare, l'ASUS AI POD XA VR721-E3.
a. Refroidissement entièrement liquide et validation à six niveaux
Étant donné qu'un seul rack XA VR721-E3 prend en charge quatre étagères d'alimentation (power shelves) de 110 kW avec des besoins en puissance de crête atteignant 227 kW, les systèmes de climatisation conventionnels ne suffisent plus. Par conséquent, ASUS a adopté une architecture 100 % refroidie par liquide et s'appuie sur des lignes d'assemblage automatisées L10/L11 équipées d'inspections optiques et d'un serrage de précision. Chaque rack doit également passer par un cadre de validation à six niveaux — comprenant des tests thermiques, de micrologiciel (firmware) et d'intégrité du réseau inter-GPU — avant d'être expédié aux fournisseurs de cloud ou aux entreprises.
b. Amener l'IA vers les PC assemblés, les stations de travail et les ordinateurs de bureau
Fait intéressant, la stratégie d'ASUS ne s'arrête pas aux salles de serveurs géantes. En plus du segment des centres de données, ASUS a également annoncé l'expansion de l'écosystème de l'IA locale vers les PC, qui englobe les composants de PC assemblés par l'utilisateur (DIY), les appareils de jeu, les stations de travail pour créateurs et les ordinateurs de bureau professionnels. Cette démarche vise à réduire le coût total de possession (TCO) pour les organisations et les créateurs qui souhaitent exécuter des flux de travail d'agents d'IA localement ou en mode hybride, sans dépendre entièrement de la location de calculs dans le cloud.
4. Feuille de route HPC 2027-2028 : Calcul scientifique et quantique
Le SC26 a également confirmé que les architectures Vera et Rubin ne sont pas seulement conçues pour les grands modèles de langage commerciaux. Dans la série d'annonces concernant la feuille de route HPC de NVIDIA, deux nouvelles gammes destinées à la communauté de la recherche scientifique ont été révélées :
- Rack HPC Vera 192-CPU (début 2027) : Une configuration dense mettant en valeur la capacité de calcul des processeurs Arm personnalisés pour les charges de travail de simulation physique, de modélisation climatique et de mémoire intensive.
- GPU Rubin HPC (2028) : Une variante dédiée au calcul scientifique de haute précision conçue pour intégrer plus de 50 000 cœurs CUDA afin de stimuler la recherche scientifique et les simulations quantiques de nouvelle génération.
Conclusion
L'événement SC26 à Chicago a montré comment la frontière entre une puce unique et l'infrastructure d'un centre de données s'est estompée. Grâce au Vera Rubin NVL72, NVIDIA prouve qu'un doublement des performances par GPU et une multiplication par 10 de l'efficacité énergétique par kilowatt ne peuvent être atteints que grâce à une conception à l'échelle du rack combinant mémoire HBM4, NVLink 6 et refroidissement liquide. Dans le même temps, l'accélération de la production de l'ASUS AI POD XA VR721-E3 et la volonté d'apporter l'accélération de l'IA locale aux stations de travail et aux PC DIY marquent le fait que cette nouvelle génération de puissance de calcul est prête à s'écouler des centres de données géants jusqu'aux bureaux des créateurs et des développeurs du monde entier.