이번 주, 글로벌 컴퓨터 및 고성능 컴퓨팅(HPC) 인프라 산업계가 **Supercomputing 2026(SC26)**을 위해 시카고에 집결했습니다. 이전 해에는 개별 칩 부족 현상이 화두를 지배했던 것과 달리, 올해 SC26의 주요 초점은 서버 랙 전체를 상호 연결된 거대한 단일 컴퓨터 유닛으로 취급하는 랙 스케일(rack-scale) 아키텍처로 완전히 이동했습니다.
주요 무대를 장식한 두 가지 대형 발표는 NVIDIA Vera Rubin NVL72의 경쟁 데뷔로, 이는 산업 표준 벤치마크인 MLPerf에서 즉시 신기록을 세웠으며, ASUS가 액체 냉각 방식의 랙 시스템인 AI POD XA VR721-E3의 양산을 가속화하고 소비자용 PC 및 워크스테이션으로 로컬 AI 접근성을 확장한다는 발표였습니다.
1. NVIDIA Vera Rubin NVL72 아키텍처 분석
단일 섀시 내의 GPU 간 통신을 제한하는 전통적인 서버와 달리, Vera Rubin NVL72 플랫폼은 랙 규모의 통합 컴퓨팅 도메인으로 설계되었습니다. DGX Vera Rubin NVL72 공식 사양서에 따르면, 단일 랙에는 72개의 NVIDIA Rubin GPU와 36개의 NVIDIA Vera CPU(Arm 호환 커스텀 코어 기반)가 통합되어 유기적으로 작동합니다.
a. HBM4 메모리 및 NVLink 6 인터커넥트의 도약
조 단위 파라미터 모델의 학습 및 AI 에이전트 추론 수요는 컴퓨팅 코어로의 초고속 데이터 공급을 요구합니다. 이에 대응하기 위해 Vera Rubin 아키텍처는 세 가지 핵심 기반을 도입합니다:
- 대규모 HBM4 용량: 각 Rubin GPU에는 최대 288GB의 HBM4 메모리가 탑재되어, 단일 랙 내에서 총 20.7 TB의 HBM4 메모리를 구현하며 초당 페타바이트 규모(구성 1.4~1.6 PB/s)의 총합 대역폭을 돌파합니다.
- 6세대 NVLink: 9개의 NVLink 6 스위치 트레이의 지원을 받아 단일 랙 내 GPU 간 스케일업 통신 경로는 216 TB/s ~ 260 TB/s에 달하며, 수천 개의 모델 파라미터가 그래디언트를 교환할 때 발생하는 병목 현상을 제거합니다.
- 고밀도 스케일아웃 네트워킹: 다수의 랙을 슈퍼컴퓨터 클러스터로 연결하기 위해, 이 시스템은 고속 InfiniBand 및 Spectrum-X 이더넷 트래픽을 지원하는 144개의 ConnectX-9 SuperNIC과 18개의 BlueField-4 DPU를 결합했습니다.
2. MLPerf Training v6.1 및 Endpoints v1.0 석권
이 새로운 아키텍처의 주장은 2026년 11월 공식 MLPerf 벤치마크 라운드에서 즉각 시험대에 올랐으며, 여기서 Vera Rubin NVL72는 이전 세대 시스템과 맞서며 첫 선을 보였습니다.
a. GPU당 학습 성능 2배 향상
MLPerf Training v6.1 공식 결과에 따르면, NVIDIA는 Vera Rubin NVL72가 철저히 최적화된 GB300 NVL72(Blackwell Ultra) 시스템에 비해 GPU당 최대 2배의 성능을 발휘한다고 밝혔습니다. 모든 테스트 카테고리를 석권한 것 외에도, 이 시스템은 클러스터를 256개에서 1,024개의 GPU로 확장할 때 97%를 상회하는 *스케일링 효율성(scaling efficiency)*을 보여주었습니다.
b. AI 에이전트 추론 에너지 효율성
한편, 에이전트 추론을 위한 MLPerf Endpoints v1.0 테스트에서는 처리량(throughput) 대 전력 소비 비율에 초점이 맞춰졌습니다. 최신 심층 추론 및 멀티모달 모델 워크로드(Qwen3-VL 및 DeepSeek 변형 등) 부하 시, Vera Rubin NVL72는 이전 세대 랙 시스템 대비 킬로와트당 10배 이상의 처리량 효율성을 기록했습니다. 이는 전기세와 냉각 비용이 AI 데이터 센터 확장의 가장 큰 걸림돌이 된 현시점에서 매우 중요한 지표입니다.
3. ASUS, AI POD XA VR721-E3 출하 가속화 및 로컬 AI 확장
생태계 파트너 제조 측면에서, ASUS는 SC26 무대를 활용해 양산 준비태세를 과시했습니다. ASUS Vera Rubin NVL72 출하 발표를 통해, 회사는 자사의 주력 유닛인 ASUS AI POD XA VR721-E3의 생산 가속화와 2026년 4분기 전면 출하를 확정했습니다.
a. 전면 액체 냉각 및 6단계 검증
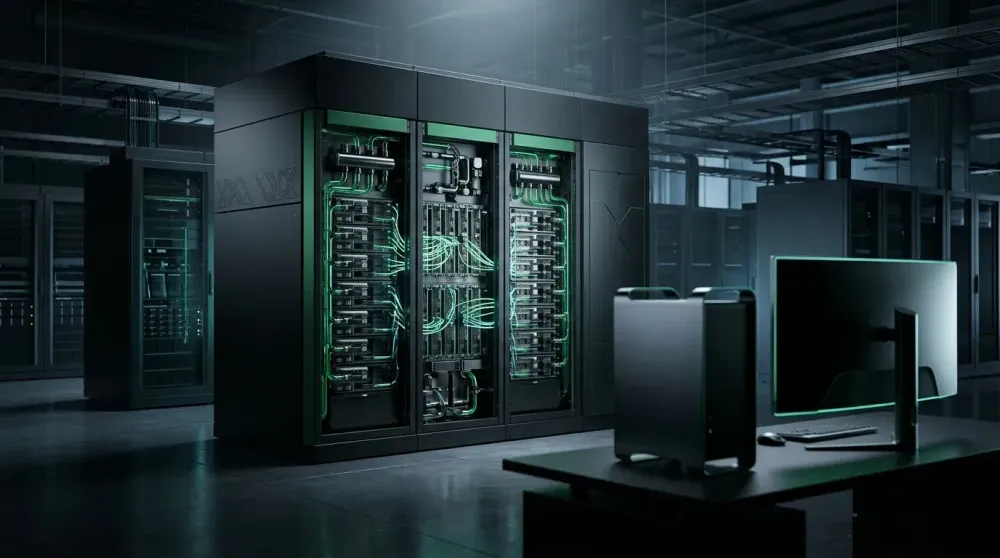
단일 XA VR721-E3 랙이 최대 227 kW의 피크 전력 요구량을 가진 110 kW 전원 셸 4개를 지탱한다는 점을 감안할 때, 기존의 공랭식 시스템은 더 이상 적합하지 않습니다. 따라서 ASUS는 100% 액체 냉각 아키텍처를 적용하고, 광학 검사 및 정밀 체결이 장착된 자동화된 L10/L11 조립 라인에 의존하고 있습니다. 각 랙은 클라우드 제공업체나 기업에 배송되기 전에 열 테스트, 펌웨어, GPU 간 네트워크 무결성을 포함하는 6단계 검증 프레임워크를 반드시 통과해야 합니다.
b. 조립식 PC, 워크스테이션 및 데스크톱으로의 AI 도입
흥미롭게도 ASUS의 전략은 거대한 서버룸에만 머물지 않습니다. 데이터 센터 부문 외에도 ASUS는 DIY PC, 게이밍 장비, 크리에이터 워크스테이션, 전문가용 데스크톱을 아우르는 Local AI 에코시스템의 PC 확장을 발표했습니다. 이 조치는 클라우드 컴퓨팅 임대에 전적으로 의존하지 않고 로컬 또는 하이브리드 환경에서 AI 에이전트 워크플로우를 실행하고자 하는 조직과 크리에이터의 총소유비용(TCO)을 절감하기 위해 마련되었습니다.
4. 2027~2028년 HPC 로드맵: 과학 컴퓨팅 및 양자
SC26은 또한 Vera와 Rubin 아키텍처가 상업용 대규모 언어 모델만을 위해 만들어진 것이 아님을 확인시켜 주었습니다. NVIDIA HPC 로드맵 발표 시리즈를 통해 연구 과학 커뮤니티를 위한 두 가지 후속 라인업이 공개되었습니다:
- Vera 192-CPU HPC 랙 (2027년 초): 물리 시뮬레이션, 기후 모델링, 대용량 메모리 워크로드를 위해 커스텀 Arm CPU 컴퓨팅 용량을 강조한 고밀도 구성.
- Rubin HPC GPU (2028): 차세대 과학 연구 및 양자 시뮬레이션을 촉진하기 위해 50,000개 이상의 CUDA 코어를 탑재하도록 설계된 고정밀 과학 컴퓨팅 특화 변형 제품.
결론
시카고에서 개최된 SC26은 단일 칩과 데이터 센터 인프라 간의 경계가 어떻게 허물어졌는지를 보여주었습니다. Vera Rubin NVL72를 통해 NVIDIA는 GPU당 2배의 성능 도약과 킬로와트당 10배의 전력 효율성이 HBM4 메모리, NVLink 6, 액체 냉각을 결합한 랙 스케일 설계를 통해서만 달성될 수 있음을 증명했습니다. 동시에 ASUS AI POD XA VR721-E3의 생산 가속화와 Local AI 가속기를 워크스테이션 및 DIY PC로 도입하려는 움직임은 이 차세대 컴퓨팅 파워가 거대 데이터 센터에서 전 세계 크리에이터와 개발자의 책상 위로 흘러 들어갈 준비가 되었음을 의미합니다.