本周,全球计算机与高性能计算(HPC)基础设施产业齐聚芝加哥,参加2026年超级计算大会(SC26)。如果说往年的讨论主要集中在单个芯片的短缺上,那么今年 SC26 的核心焦点已完全转向了**机架级(rack-scale)**架构,即把整个服务器机柜当作一个相互连接的巨型计算机单元来处理。
两项重大发布占据了主旨舞台:NVIDIA Vera Rubin NVL72 的首次公开竞技亮相便在 MLPerf 行业基准测试中创下新纪录,以及**华硕(ASUS)**加速交付液冷机架系统 AI POD XA VR721-E3 的大规模出货,同时将本地 AI 访问权限扩展至消费级 PC 和工作站。
1. NVIDIA Vera Rubin NVL72 架构剖析
与传统服务器限制单个机箱内 GPU 之间的通信不同,Vera Rubin NVL72 平台被设计为机架规模的统一计算域。根据 DGX Vera Rubin NVL72 官方规格表,单个机架集成了 72 个 NVIDIA Rubin GPU 和 36 个 NVIDIA Vera CPU(基于兼容 Arm 的定制内核),协同工作。
a. HBM4 内存飞跃与 NVLink 6 互连
训练万亿参数模型和 AI 智能体推理的需求,要求向计算核心提供极其快速的数据供给。为了应对这一挑战,Vera Rubin 架构带来了三大基础支撑:
- 海量 HBM4 容量: 每个 Rubin GPU 配备高达 288 GB 的 HBM4 内存,单个机架的总 HBM4 内存高达 20.7 TB,聚合带宽达到每秒拍字节级别(根据配置约为 1.4–1.6 PB/s)。
- 第六代 NVLink: 在九个 NVLink 6 交换机托盘的支持下,机架内 GPU 之间的纵向扩展(scale-up)通信路径达到了 216 TB/s 至 260 TB/s,消除了模型参数互换梯度时的瓶颈。
- 高密度横向扩展网络: 为了将多个机架连接成超级计算机集群,该系统结合了 144 个 ConnectX-9 SuperNIC 和 18 个 BlueField-4 DPU,以支撑高速 InfiniBand 和 Spectrum-X 以太网流量。
2. 横扫 MLPerf Training v6.1 与 Endpoints v1.0
该新架构的声明立即在 2026 年 11 月的官方 MLPerf 基准测试中接受了检验,Vera Rubin NVL72 首次亮相,迎战上一代系统。
a. 每个 GPU 的训练性能提升 2 倍
在 MLPerf Training v6.1 官方结果中,NVIDIA 指出,与经过充分优化的 GB300 NVL72(Blackwell Ultra)系统相比,Vera Rubin NVL72 能够实现每个 GPU 高达 2 倍的性能。除了在所有测试类别中大获全胜外,当集群从 256 个扩展到 1,024 个 GPU 时,该系统还表现出超过 97% 的扩展效率(scaling efficiency)。
b. AI 智能体推理能效
同时,在 MLPerf Endpoints v1.0 智能体推理测试中,焦点转移到了吞吐量与功耗比上。在现代深度推理和多模态模型(如 Qwen3-VL 和 DeepSeek 变体)的工作负载下,Vera Rubin NVL72 的吞吐量能效比上一代机架系统提高了每千瓦 10 倍以上——考虑到电费和冷却成本目前是 AI 数据中心扩张的最大制约因素,这是一个至关重要的指标。
3. 华硕加速 AI POD XA VR721-E3 交付与本地 AI 扩展
在生态系统合作伙伴制造端,华硕利用 SC26 的舞台展示了其大规模生产的准备就绪。通过华硕 Vera Rubin NVL72 发货公告,该公司确认其旗舰产品 ASUS AI POD XA VR721-E3 将在 2026 年第四季度加速全面生产和发货。
a. 全液冷与六层验证
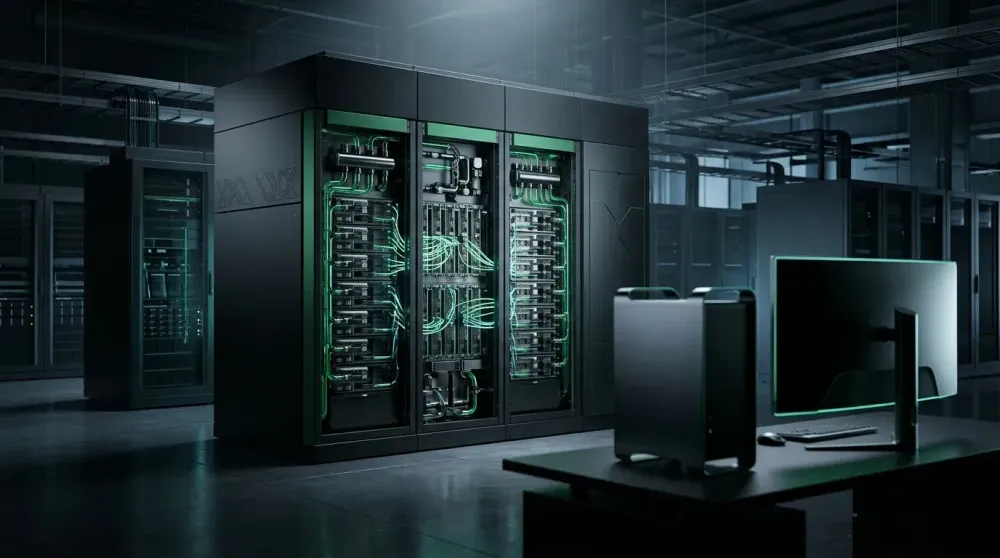
鉴于单个 XA VR721-E3 机架支持四个 110 kW 电源架,峰值功耗需求高达 227 kW,传统的空气冷却系统已不再够用。因此,华硕采用了 100% 液冷架构,并依托配备光学检查和精密紧固的自动化 L10/L11 组装线。在运往云服务商或企业之前,每个机架还必须通过六层验证框架——涵盖热测试、固件以及跨 GPU 网络完整性。
b. 将 AI 引入组装 PC、工作站和台式机
有趣的是,华硕的战略并未止步于巨型服务器机房。在数据中心细分市场之外,华硕还宣布了将本地 AI 生态系统扩展到 PC,涵盖 DIY PC 组件、游戏设备、创作者工作站以及专业台式机。此举旨在降低组织和创作者的总拥有成本(TCO),他们希望在本地或混合模式下运行 AI 智能体工作流,而不完全依赖于租用云端算力。
4. 2027–2028 年 HPC 路线图:科学计算与量子计算
SC26 还强调,Vera 和 Rubin 架构不仅是为商业大语言模型而构建的。在NVIDIA HPC 路线图系列公告中,为科学研究社群披露了两条后续产品线:
- Vera 192-CPU HPC 机架(2027 年初): 突出定制 Arm CPU 计算能力的密集配置,用于物理模拟、气候建模和大型内存工作负载。
- Rubin HPC GPU(2028 年): 专为高精度科学计算设计的专用变体,旨在引入超过 50,000 个 CUDA 核心,以推动下一代科学研究和量子模拟。
结论
芝加哥 SC26 大会展示了单芯片与数据中心基础设施之间的界限是如何融为一体的。通过 Vera Rubin NVL72,NVIDIA 证明了每个 GPU 2 倍的性能飞跃和每千瓦 10 倍的功率效率,只能通过融合 HBM4 内存、NVLink 6 和液冷的机架级设计来实现。与此同时,ASUS AI POD XA VR721-E3 生产的加速以及将 Local AI 加速推向工作站和 DIY PC 的推动力标志着,新一代计算能力已准备好从巨型数据中心流向全球创作者和开发者的桌面。